首次建立苹果CMS进行各源数据的全量采集时,由于数据动辄几千页,在后台点击全量采集后可能需要十几个小时才能完成。由于网络波动或超时,采集中途极其容易中断,而系统有时又不会自动给出断点续采提示,如果直接重新开始,此前花费的数小时时间就白白浪费了。
一、采集原理与 URL 结构分析
通常在苹果CMS的「采集 – 自定义接口」界面,我们可以针对指定资源库选择「采集当天」、「采集本周」或「全量采集」。这几个按钮本质上都是对应一个特定的采集 API 请求 URL。
我们只需在按钮上右键选择「复制链接地址」,或者在点击进入采集界面后,观察浏览器顶部地址栏的完整 URL:
https://your-domain.com/admin/collect/api.html?ac=xxxx&year=¶m=&page=1可以看到,控制当前采集进度精确定位的就是末尾的 page=1 参数。
二、断点续传精确定位与恢复流程
1. 已知中断的大概页码
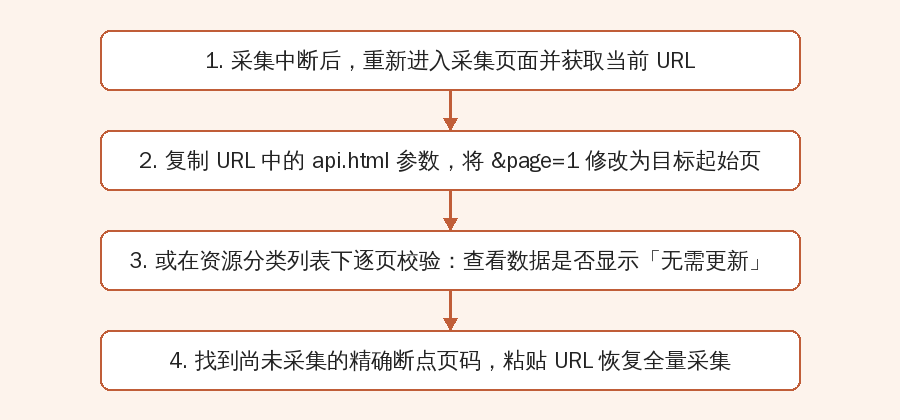
如果你大概知道中断时跑到了第几页(比如日志显示到第 250 页时连接断开),重新点击该接口的全量采集,当页面跳转到 page=1 开始执行时,直接在浏览器地址栏把末尾的 page=1 修改为 page=250 并按回车提交,系统就会立刻跳过前 249 页,直接从第 250 页恢复采集。
2. 未知中断点时的快速检测法
若不清楚精确中断页数,可以通过以下步骤二分定位:
- 进入「采集 – 自定义接口」界面,点击目标资源名称进入分类数据列表页;
- 在列表页下方的「到页」输入框中,输入预估的页码(例如总页数 500 页,可输入 250 页);
- 勾选列表中的几条视频记录,点击下方的「采选中」;
- 观察采集中转窗口:若提示信息全为
无需更新,说明该页在此前已成功入库;若出现新增入库或数据更新,说明此前采集尚未覆盖到此页; - 利用二分查找快速缩减区间,锁定断点页码后,直接修改地址栏
page=N恢复后续采集。
发表回复