作为一名习惯了与数据和网络协议打交道的通信工程老兵,退休之后,我依然习惯用”工程化与闭环思维”来管理自己的日常生活。近几个月,我通过室内动感单车做 Zone 2 有氧耐力训练,配合日常快走、慢跑以及晨起血压监测,心血管指标有所改善。
但日常记录中,痛点很明显:数据孤岛。血压在可孚血压计里,体脂在海尔”渐轻”App 里,运动和心率在佳明(Garmin Fenix 7)里。每天手动切换 App 记录、对比,费时费力;更缺一个跨维度的”总账中枢”,来评估运动负荷与自主神经恢复之间的动态平衡。
为此,我利用甲骨文(OCI)云服务器、Hermes AI Agent、Telegram 专属话题以及 Garmin 官方云端接口,搭建了一套端到端的个人全自动化健康与运动生理量化中枢。本文记录从底层通信排坑、硬件物理校准到大模型生理推理的完整搭建过程。
一、系统架构设计与交互蓝图
整套系统的架构核心是:让客观数据自动化闭环,让大模型只做深度生理归因。
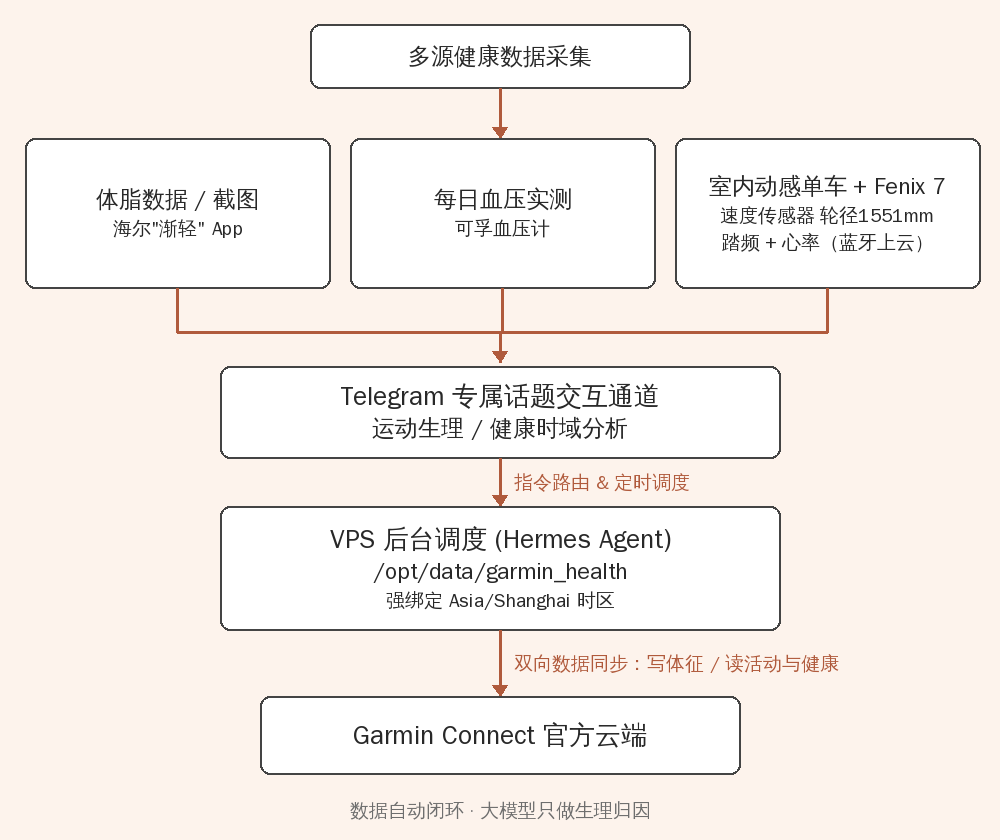
日常交互完全在 Telegram 的独立话题中完成:
- 随手记:输入
血压 128 82 76或体重 65.6 20.4(亦可直接发体脂秤截屏),后台自动解析并写入 Garmin 数据库; - 查底色:输入
今日,即刻调出包含步数、昨夜睡眠、静息心率与夜间 HRV 的健康底色; - 定时总账:每晚 23:00(北京时间)自动推送全天总账卡片,末尾附大模型生理分析(第五节详述);
- 趋势复盘:每周日与每月 1 日随总账自动附 30 天月线走势图;平时输入
月线或月报即时出图。
二、基础排坑:时区漂移、免密 Token 与接口暗坑
VPS 与 Garmin Connect API 联调过程中,遇到几个典型的底层工程问题。
1. 异地风控与本地 Token 持久化
海外 VPS 直连 Garmin 官方接口,频繁用明文密码重新握手极易触发异地登录风控。解决方式:在 /opt/data/.garmin_tokens 落地持久化凭据,脚本启动时优先读本地 Token,仅在 401/403 时才重新登录,会话因此长期稳定。
2. 时区漂移与步数多时间桶计算
- 时区锁死:VPS 系统是 UTC,直接读取会导致北京时间每天早晨 08:00 之前的数据归入前一天。数据拉取与定时器全部强制绑定
ZoneInfo("Asia/Shanghai")。 - 步数修复:Garmin 返回的步数常拆成多个时间分片桶(Buckets),初版脚本只取第 0 个桶(凌晨为 0 步),排查后改为对全天分片求和,才与手表显示对齐。
3. 提取深层嵌套的夜间睡眠 HRV
HRV(心率变异性)是评估副交感神经活性与恢复状态的黄金指标,Garmin 把它藏在睡眠对象的多层 JSON 里。向下挖到 avgOvernightHrv 与 lastNightAvg,才稳定取出以毫秒为单位的夜间基线。
三、硬件校准:动感单车速度与距离的实测反推
骑动感单车最大的困扰是手表记不到里程、室内骑行没有速度。为了让每次训练产出”心率-踏频-时速”三通道完整的 .FIT 原始流,我给飞轮加装了外置速度与踏频传感器。
但动感单车飞轮与真实公路车轮物理特性不同,轮径必须严格校准。一次 60 分钟实测拿到对标数据:
| 校准项目 | 数值 |
|---|---|
| 单车仪表里程 | 18.4 km |
| 手表初始里程(设定轮径 1414 mm) | 16.77 km |
| 比例系数 K | 18.4 ÷ 16.77 ≈ 1.0972 |
| 目标轮径 C | 1414 × 1.0972 ≈ 1551.4 mm → 传感器设定 1551 mm |
| 校准后验证 | 巡航时速约 18.5 km/h,总里程与仪表吻合(误差 < 1%) |
传感器磁吸感应转数与踩踏完全线性,两者纯属轮径比例问题。在 Fenix 7 的传感器设置中把轮径精确设为 1551 mm,校准后再骑,手表实时巡航时速(约 18.5 km/h)与总里程和单车自带仪表完全吻合,消除了近 10% 的系统误差。
四、热量对齐:官方 Firstbeat 算法 vs 本地自算
抓取运动热量时走过弯路:初期卡片显示活动消耗只有 61.0 kcal,而 Garmin Connect 手机端清楚显示运动消耗 281 kcal。
排查结果是字段取值错误:
- 61.0 kcal 只是日常散步与基础活动产生的轻度活动热量;
- 佳明用 Firstbeat 专有生理学算法,基于心率变异度、最大摄氧量和个人参数估算训练做功,单次 60 分钟单车的真正消耗封装在具体 Activity 的
calories字段里(270 kcal); - 最终方案:全天活动热量强制取
get_user_summary()的官方activeKilocalories(精确对应 App 的”运动 281 kcal”),单项明细读act.get('calories'),彻底弃用本地公式估算。
五、从冷冰冰的数据到智能推理:大模型的生理学交叉归因
搭自动化系统最容易犯的毛病,是把大模型当排版脚本,只输出千篇一律的套话。我的做法是:数据归脚本,归因归模型,并给模型立三条纪律——【1】【2】【3】节数据逐字保留、禁止编造任何数值、分析必须引用具体数字。
每晚 23:00,数据脚本先拉取当日全部体征,注入大模型上下文,模型在卡片末尾生成生理态势感知与行动建议。以下是基于 2026-10-12 实测数据生成的一次推送卡片:
这种分析给出的不仅是数据,而是带明确行动边界的安全指导(如设定静息心率上浮 5 bpm 即触发降阶熔断),真正起到了”私人运动生理医生”的辅助作用。
六、周期性趋势图与推送调度节奏
为了防止每日信息过载,在信息架构上采取了”动静分离、长短结合”的推送策略:
- 周一至周六 23:00:只发送上述文字总账卡片,保持手机端阅读简洁;
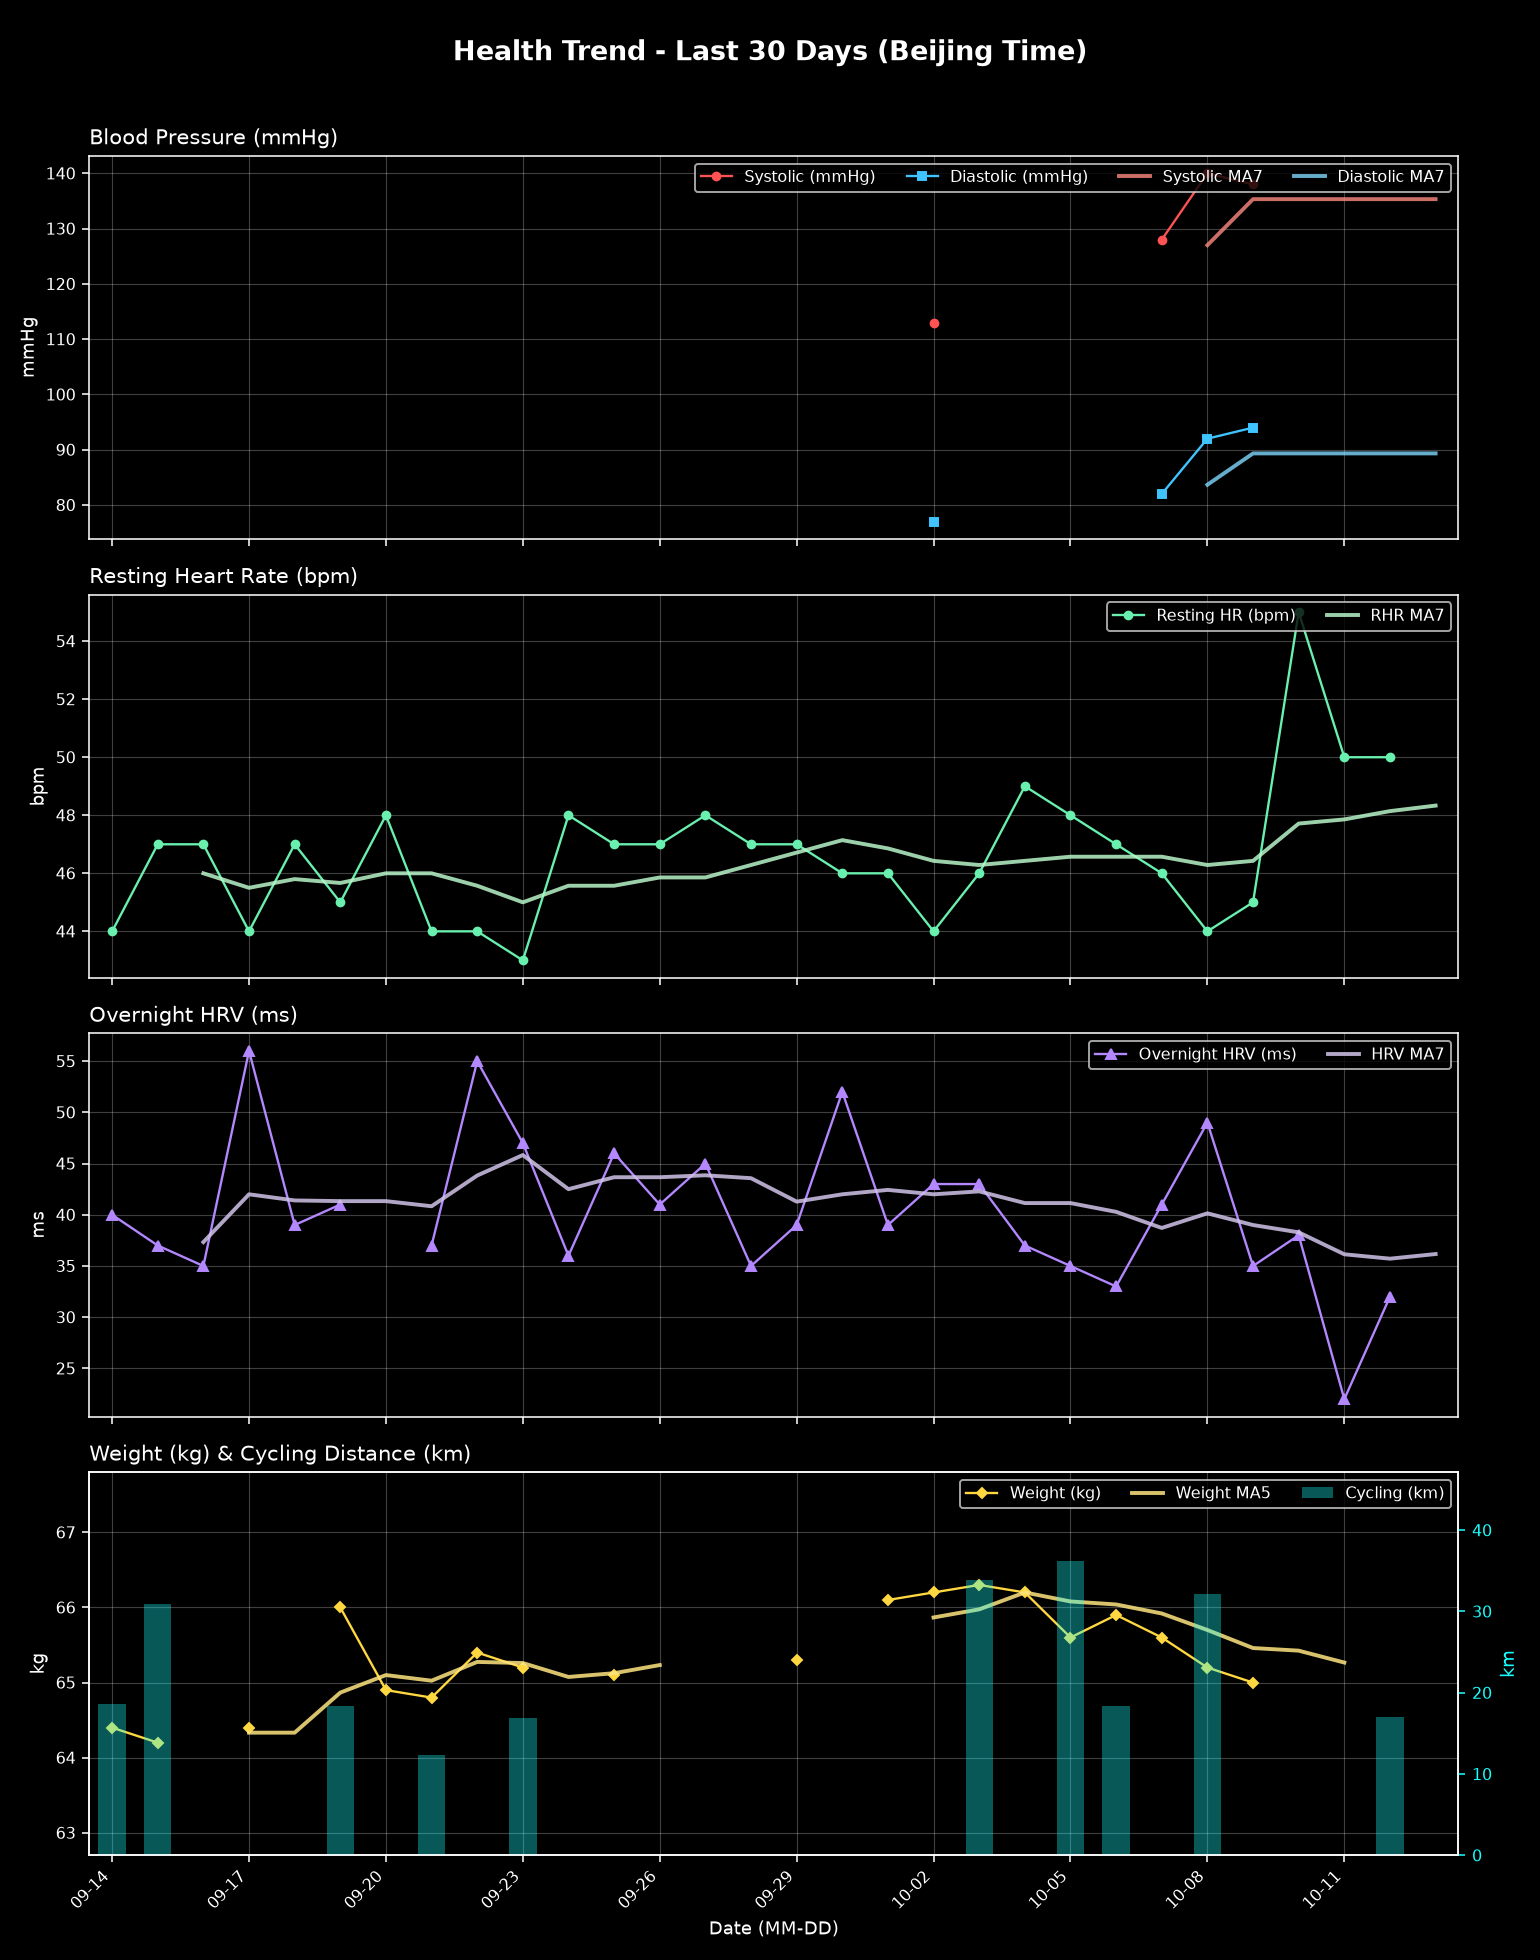
- 周日晚与每月 1 日:在文字卡片后自动追加生成 30 天月度趋势图(4 子图:血压走势、静息心率、夜间 HRV、体重与单车里程),带 7 日滑动平均线,图例采用英文避免 Linux 环境字库乱码;
- 日常交互:在 Telegram 话题中随时输入
月线或月报,后台即时生成并回传原图。
结语
技术从来不是年轻人的专利。从早年搭建通信交换网络,到今天在 Linux VPS 上通过 Docker、Python 和 AI Agent 调度自己的身体健康,工程逻辑的底层是相通的:客观测量、精准对标、自动闭环、安全冗余。
将日常的每次踩踏、每次睡眠和血压波动纳入自动化数字中枢,不仅让退休生活增添了动手的乐趣,更让身体的每一项微小改变都有迹可循、胸有成竹。
发表回复