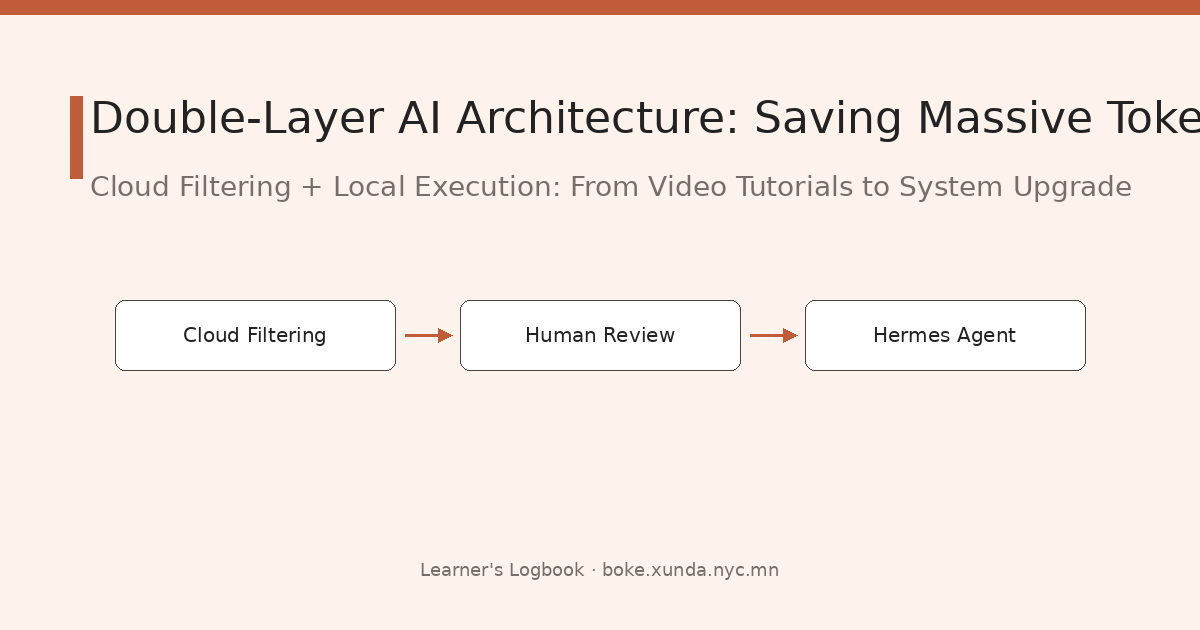
文章摘要 (Excerpt):面对动辄数万字的视频教程与材料,直接让私有 Agent 抓取不仅烧 Token、污染记忆,更极易因瞬时高并发直接触发免费 API 的 429 限流报错。本文分享了一套“云端通用大模型负责重度过滤提炼 + 人工审查 + 私有 Hermes Agent 精准执行”的双层架构实战心得。
在个人 VPS 上跑起自己的 Hermes Agent 之后,系统逐渐从最初的“环境跑通”进入到了“日常好用”的阶段。
最近社区关于各类 AI Agent 的讨论、评测和进阶玩法层出不穷,YouTube 上每天都有大量标题耸动的教程。作为一个喜欢折腾但精力有限的技术老兵,面对动辄十几分钟甚至三小时的冗长视频,如果自己逐一去啃,眼睛受不了;如果直接把视频链接丢给跑在云端的 Hermes Agent 啃,不仅容易被各种垃圾信息挤爆上下文(Context Window),还会带来更致命的连锁反应。
偶然摸索出来的“双层 AI 协作工作流”,彻底解决了这个痛点。
一、 传统做法的致命缺陷:Token 爆炸、记忆污染与频繁 429 报错
很多人习惯有了本地或私有 Agent 之后,直接给它装个网页/视频抓取插件,甩个链接说:“把这个视频看了,总结一下有什么好用的,给我做出来。”
看似省心,实际上在工程和成本上是一笔极亏的买卖:
- 瞬时吞吐打满,频频触发 429(Rate Limit)截断:个人部署大多会利用各大平台的免费/轻量 API(如 Google AI Studio、GitHub Models 或各类免费中转层)。这些免费端点对 RPM(每分钟请求数) 和 TPM(每分钟 Token 吞吐量) 有着极其苛刻的阈值。一段视频字幕或长文档动辄上万甚至数万 Token,Agent 在拆解、反思和多轮工具调用时,会瞬间打爆 TPM 限制,直接招致 HTTP 429 Too Many Requests 错误。任务跑到一半突然卡死崩溃,不仅白白消耗了前面的额度,还搞乱了当前的执行状态。
- Token 账单灾难:如果换成按量付费的商业 API,一个 15 分钟的视频通常有 8,000 ~ 15,000 Token;3 小时的系统课甚至高达近 10 万 Token。而视频里 80% 以上是“点赞投币”、“买我的云服务”、“看我点击鼠标”等废话。直接喂给私有 Agent,意味着你必须为这些垃圾数据真金白银地买单。
- 上下文与记忆污染(Context Bloat):LLM 有明显的注意力衰减效应。当数万字的无效台词涌入上下文,Agent 的主推理能力会断崖式下跌,甚至会把视频里偶然的口误或测试环境下的特殊命令写进
MEMORY.md,造成长期记忆污染。 - 缺乏全局架构判断:很多视频只教你怎么跑通一个玩具脚本,并不考虑你的云端网络链路、系统权限隔离和现有生态,盲目执行往往把原本干净的环境搞得一团糟。
二、 破局方案:“前沿技术过滤器 + 本地特种兵”双层分工
我采取的做法是将整个技术吸收过程解耦为两层:
Plaintext
  [海量视频/文章/噪音]
           │
           ▼
┌────────────────────────┐
│  云端大模型 (分析大脑)    │  <-- 脏活累活:啃万字字幕、过滤带货、扛住长文本吞吐
└──────────┬─────────────┘
           │ 输出:几百 Token 的结构化工程指令 (干净、精准、零废话)
           ▼
┌────────────────────────┐
│   我 (指挥官 / 审查)     │  <-- 过目确认,保留控制权,防盲目自治
└──────────┬─────────────┘
           │ 转发下发指令 (平缓单次低 Token 请求,告别 429)
           ▼
┌────────────────────────┐
│ Hermes Agent (执行手脚) │  <-- 零垃圾输入,以极低消耗落盘 Skill / 修改配置
└────────────────────────┘
- 第一层:云端通用大模型(规划大脑 / 过滤器)将视频链接直接丢给处理长文本能力强的通用大模型。让它扮演“严格的技术初审官”,由它在自己的平台上承担超大吞吐的计算,不仅提取核心观点,而且明确过滤掉推销广告、新手安装等基础内容,只针对我现有的云端环境提炼 2~3 个最具落地价值的底层思路与核心配置。
- 第二层:人工过目(安全边防)避免让 Agent 成为脱缰野马。我只需花 30 秒扫一眼提炼出的要点,确认这套逻辑适合我目前的网络环境与生活习惯,便批准采纳。
- 第三层:Hermes Agent(本地特种兵 / 执行手脚)将这几百个 Token 的纯骨干指令直接丢给 Hermes。Hermes 拿到的是最标准的技术需求说明,不用看视频、不用猜意图,不仅单次调用 Token 极少、彻底避免了免费 API 触发 429 报错的尴尬,还能干净利落地在服务器内部编写 Skill 脚本、修改配置文件。
三、 实战战果:从社区实践中淘到的真金白银
通过这套工作流,我一口气过筛了近期社区最火的几套 Agent 视频,剔除了 90% 的口水话,沉淀了几个扎实的系统升级点:
- 任务分流与高可用防爆:
- 采纳 Task-level Sub-models 策略:视觉识别、大文档压缩走轻量/免费模型,复杂的系统推理和记忆归纳走高智商模型。
- 引入 Skill Retriever(动态技能检索):不再把几十个 Skill 描述全部硬塞给每一轮对话,按需检索注入,单轮对话直接省下上万 Token,彻底杜绝了并发吞吐超标导致的限频。
- 外部超大记忆库外挂(NotebookLM + Skill):
- 不在本地硬跑吃资源又烧钱的传统向量 RAG,而是把 Google NotebookLM 封装成 Hermes 的外部工具。平时把长材料直接由 Agent 推入 NotebookLM,由其免费消化数百万字,并一键调用其原生能力生成对谈播客或测验题。
- 安全与系统防灾底线:
- 将终端执行环境切换为 Docker 沙箱隔离,防范 Agent 自主运行潜在破坏性指令;
- 严格核查 IM 桥接的 Allow List(填本人账号 ID 而非 Bot ID),并开启静默忽略未授权消息,保障云端中枢的纯净与安全。
四、 一点折腾感悟
很多朋友在玩 AI Agent 时容易陷入两个极端:要么把它当成一个普通聊天框在用;要么试图给它完全放权,指望它全自动解决一切。
其实最舒服的状态是“各司其职”:
- 繁重的高吞吐长文本过滤交给云端通用大模型;
- 具体的系统落地与本地执行交给常驻 Agent;
- 关键的决策与方向把控留给自己。
不用费眼去刷漫长的视频教程,也不用担心脆弱的免费 API 因为超频报错而罢工。每天泡上一杯茶,让系统在后台稳稳运转,这才是业余折腾技术最惬意的姿态。
发表回复