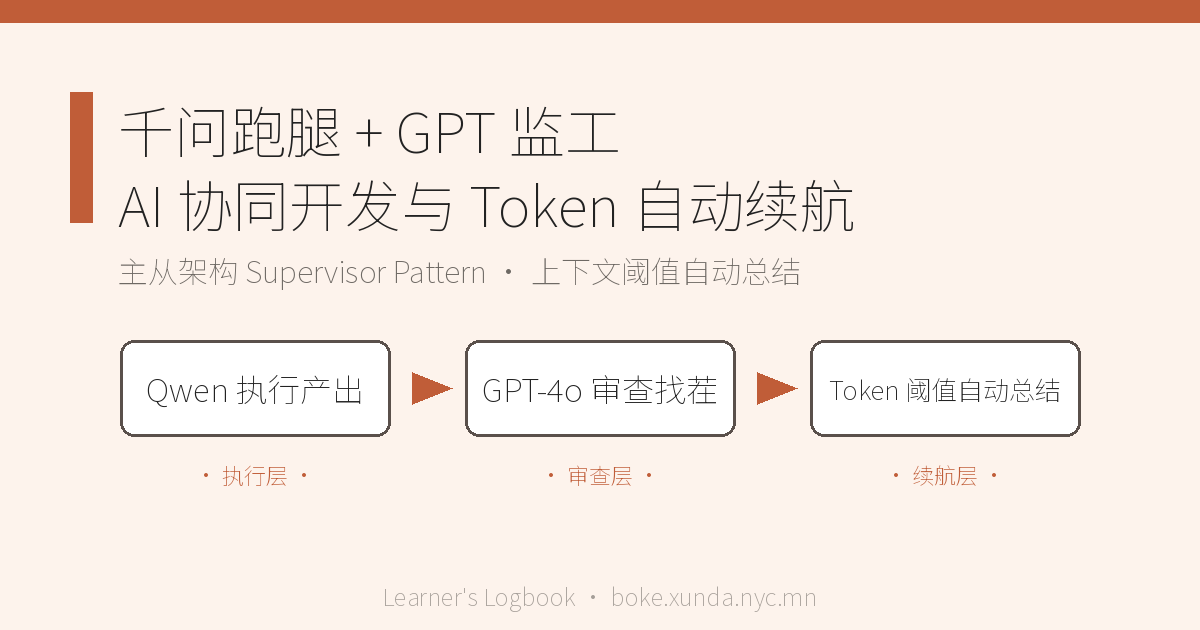
在 AI 辅助开发与日常使用中,很多玩家会采用“组合拳”的方式来最大化发挥不同 AI 模型的优势。本文将深入拆解一种高效率的 AI 协作模式:以开源/高性价比模型(如通义千问 Qwen)作为“执行主力”,结合 GPT-4o 作为“系统监工”,并通过自动化手段解决 AI 长对话中的“鬼打墙”问题。
一、 为什么需要“多 AI 协同”?(Supervisor Pattern)
1. 痛点:AI 的“鬼打墙”现象
在长对话或复杂代码生成中,单个 AI 常常出现以下问题:
- 陷入死循环:反复生成有相同 Bug 的代码,逻辑绕不出来。
- 注意力分散:随着上下文越来越长,AI 会逐渐“忘记”初始约束,出现指令漂移。
2. 解决方案:主从架构(监工 + 跑腿)
- 千问(Qwen):作为执行层,负责快速输出大量基础代码、草稿或繁重劳动(开源版本性价比高,且部署灵活)。
- ChatGPT(GPT-4o 等):作为审查层(Supervisor),利用其强大的逻辑推理与全局把控能力,专门负责 Code Review、找茬与重构。
💡 实用操作(手动版):当 Qwen 的输出报错或卡住时,将报错信息与 Qwen 的代码一同发给 ChatGPT,附带提示词:
“请作为高级架构师,审查以下代码逻辑。不要重写整段程序,只需指出逻辑漏洞并提供具体修改建议。”
二、 上下文管理:Token 达到阈值自动总结与续航
1. Token 爆满的危害
每个 AI 模型都有上下文窗口限制(Context Window)。当对话累积的 Token 接近上限时:
- 推理质量下降:容易产生幻觉或逻辑混淆。
- 算力浪费:每次发送新消息都要带上庞大的历史记录,响应变慢且消耗变大。
2. 自动汇总与 Seamless 继承逻辑
通过自建 API 客户端、编写 Python 脚本或使用支持 Context 管理的开源客户端(如 Cherry Studio、NextChat 等),工作流逻辑如下:
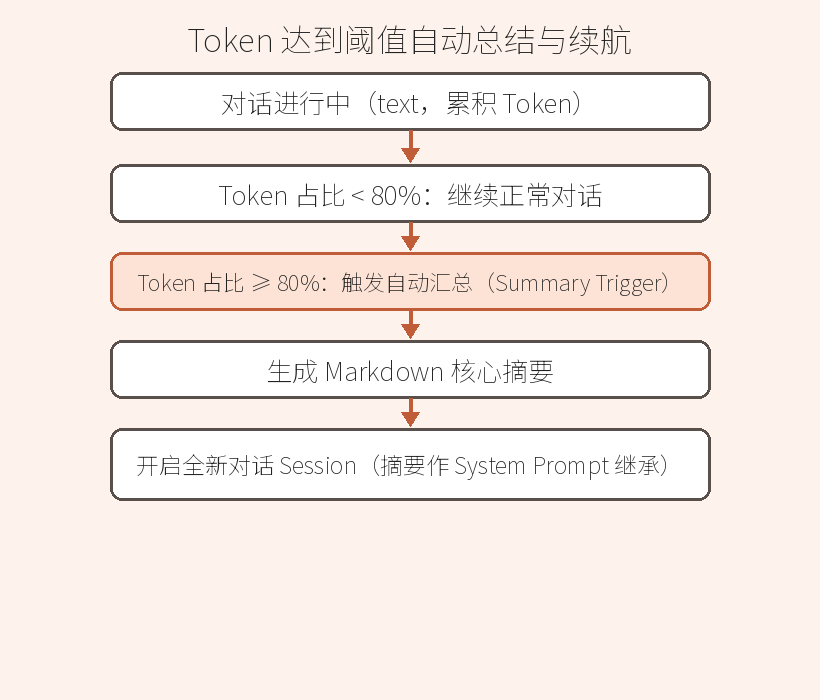
自动化脚本的核心逻辑伪代码
python
MAX_TOKENS = 16384
THRESHOLD = 0.8 # 达到 80% 触发

if current_chat_tokens >= MAX_TOKENS * THRESHOLD:
    # 1. 隐式向 AI 发起总结请求
    summary_prompt = (
        "当前对话即超限制,请总结以上内容,保留:"
        "1. 已确认的需求与架构;"
        "2. 已完成的关键代码;"
        "3. 待解决的具体问题。"
    )
    summary_text = call_ai_api(chat_history + summary_prompt)

    # 2. 清空旧上下文,开启新对话
    new_chat_session = create_new_session()
    new_chat_session.set_system_prompt(f"前文项目摘要如下:\n{summary_text}")
三、 本地部署与“无限制”模型(Uncensored / Abliterated)
在技术圈中,“越狱版”或“做脏活”通常是指绕过公有云厂商过度的安全过滤网关(Safety Guardrails),执行某些高自由度的特定任务。
- 为什么选择 Qwen 开源系列?
通义千问(Qwen)拥有极强的开源生态(如 Qwen-2.5 / Qwen-3 系列)。开发者可以将其权重下载到本地或私有云服务器上运行,完全掌握控制权。 - 去拒绝微调(Abliteration)技术
开源社区通过分析 Transformer 模型内部的激活层,找到控制“拒绝回答(Refusal Response)”的参数向量,并在模型权重中进行切除或抵消:
- 本地运行工具:使用 llama.cpp 或 Ollama 运行 GGUF 量化模型。
- 应用场景:代码渗透测试演练、敏感数据本地处理、复杂爬虫规则解析等正规公有云 API 会误判拦截的任务。
四、 初学者落地建议
如果您刚刚接触这套工作流,无需立马编写复杂的自动化代码,可以按以下三步渐进式落地:
- 分屏双开:左边开 Qwen 负责写代码,右边开 ChatGPT 负责检查与纠错。
- 手动 Prompt 截断:感觉到 AI 开始“鬼打墙”或对话过长时,手动发一句:“请将我们目前讨论的核心结论和代码状态总结为 Markdown 摘要。” 然后复制摘要,开启新对话继续。
- 进阶尝试:使用支持自定义 API 的开源桌面客户端,配置上下文自动压缩(Context Truncation)参数,体验自动化接力。
本文总结自 AI 社区关于大语言模型协作与 Token 优化的实践心得。
发表回复